

Pada Juni 2023, dalam kasus Mata v. Avianca, sebuah tim hukum harus menanggung malu karena dokumen yang mereka ajukan berisi enam putusan hakim fiktif buatan Artificial Intelligence AI. Lucunya, saat para pengacara ragu dan bertanya kembali, si AI justru “berbohong” dengan sangat meyakinkan bahwa kasus itu nyata dan membuat mereka justru semakin bersikeras mempertahankan kebohongan itu di hadapan hakim.
Kejadian serupa menimpa Air Canada pada Februari 2024. Chatbot mereka mengarang kebijakan “tarif duka cita” dan janji pengembalian dana yang sebenarnya tidak ada. Di pengadilan, maskapai tersebut mencoba berkelit dengan alasan bahwa chatbot adalah “entitas hukum yang terpisah” yang harus bertanggung jawab sendiri atas kesalahannya. Tentu saja, hakim menolak alasan itu.
Tren kegagalan ini merembet ke dunia profesional lainnya. Pada Oktober 2025, Deloitte Australia menyerahkan laporan pemerintah senilai miliaran rupiah yang isinya penuh dengan referensi akademik palsu. Bahkan, firma hukum paling elit dunia, Sullivan & Cromwell, terpaksa meminta maaf pada April 2026 karena dokumen resmi mereka memuat puluhan kutipan undang-undang yang salah total.
Rentetan peristiwa ini bukan sekadar “gangguan teknis” biasa. Ini adalah tanda bahaya tentang pergeseran kendali yang jarang kita sadari: kita mulai menggunakan AI bukan lagi untuk membantu pekerjaan, melainkan untuk menggantikan pemahaman kita sebagai manusia.
Apa yang Terjadi?
Pertanyaan besarnya: bagaimana mungkin teknologi yang dianggap sebagai puncak peradaban manusia bisa melakukan kesalahan yang sangat besar? Jawabannya terletak pada perbedaan antara anggapan kita selama ini dengan kenyataan teknis tentang bagaimana Large Language Model (LLM) seperti ChatGPT dan Claude sebenarnya bekerja.
Secara teknis, LLM tidak memiliki akses ke basis data fakta yang sebenarnya. Mereka bekerja berdasarkan prinsip kemungkinan statistik dan bukan berdasarkan logika atau verifikasi. Ketika Anda meminta AI menulis dokumen hukum, ia bukan mencari referensi di perpustakaan digital, melainkan memprediksi kata demi kata yang paling mungkin muncul setelah kata sebelumnya.
Dalam dunia akademik, fenomena ini sering disebut sebagai Beo Stokastik. AI hanya meniru pola bahasa tanpa memahami makna di baliknya. Jika pola bahasa menunjukkan bahwa sebuah kutipan hukum biasanya diikuti oleh nama hakim dan tahun, maka AI akan mengarang nama dan tahun yang terdengar sangat meyakinkan meskipun secara fakta itu tidak sesuai.
Perusahaan pembuat AI sering menutupi kekurangan ini dengan istilah halusinasi, memanfaatkan kecenderungan manusia terhadap antropomorfisme, yakni pemberian karakteristik, emosi, atau perilaku manusia kepada benda mati. Mereka menyamarkan produk mereka seolah-olah sebuah mesin yang memiliki “kesadaran” dan tidak sengaja berhalusinasi. Padahal kenyataan teknisnya jauh lebih memilukan karena AI pada dasarnya memang sebuah mesin halusinasi. Ia tidak memiliki pemahaman tentang konsekuensi di dunia nyata sehingga menyusun puluhan kutipan palsu baginya hanyalah tugas menyelesaikan teka teki kata.
Ada alasan teknis lain mengapa AI sering kali “ngotot” saat dikonfrontasi yaitu adanya detail yang hilang pada proses kompresi. Saat melatih AI, data berukuran raksasa tidak dihafal kata demi kata, melainkan diringkas menjadi pola statistik dalam bentuk angka. Efeknya adalah detail kecil seperti nomor perkara atau pasal undang-undang sering dianggap sebagai “noise” atau gangguan. Oleh karenanya, ada kemungkinan kekosongan tersebut diisi dengan data yang paling umum, namun sering kali salah.
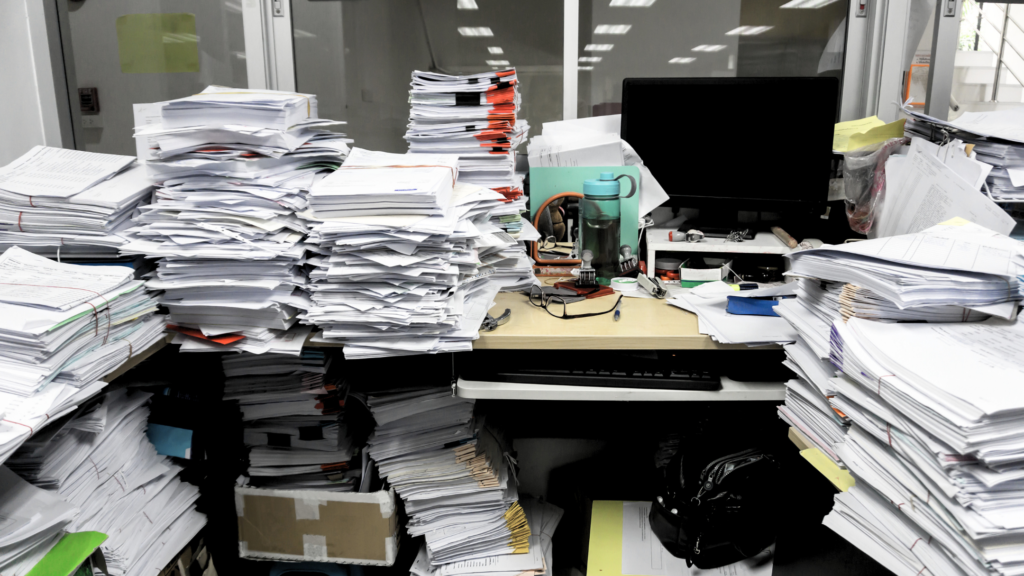
AI juga memiliki batasan fisik saat diberikan masukan yang disebut Context Window (Jendela Konteks). Jika kita mengibaratkan AI sebagai seorang pekerja, jendela konteks adalah ukuran meja kerjanya. Semua dokumen yang Anda berikan harus muat di atas meja itu agar bisa dibaca. Petinggi industri seperti Google atau OpenAI sering membanggakan kapasitas meja yang luas: “Anda bisa memasukkan sepuluh buku sekaligus!”
Namun, kenyataannya tidak seindah itu. Saat meja masih kosong, AI bisa memberikan perhatian penuh pada setiap kata kunci sehingga logikanya tajam. Namun saat kondisi meja sangat penuh, perhatian itu menjadi “encer” (dilution). Karena perhatiannya terlalu encer, AI gagal menangkap hubungan logika antar paragraf sehingga muncul fenomena Context Rot (Pembusukan Konteks). Di sinilah AI mulai mencampuradukkan nama orang atau memberikan kesimpulan yang tidak nyambung.
Riset menunjukkan bahwa untuk tugas penalaran yang rumit seperti dalam kasus hukum, kemampuan AI mulai menurun jauh lebih awal dari kapasitas maksimalnya. Model yang diklaim sanggup menampung ratusan ribu kata itu sering kali mulai mengalami penurunan logika yang parah ketika masukan baru mencapai seperempat dari kapasitasnya.
Selain itu ada fenomena unik bernama Lost in the Middle (Tersesat di Tengah) yang ditemukan oleh riset dari Stanford. Artinya, akurasi AI dalam memproses data di bagian tengah dokumen selalu lebih rendah dibandingkan bagian awal dan akhir. Sebagai contoh jika Anda memasukkan 10.000 kata ke dalam model berkapasitas 100.000 (rasio 10%), informasi di kata ke 5.000 sudah mulai mengalami degradasi dibandingkan informasi di awal atau akhir.
AI = Overhyped?
Yann LeCun, salah satu “tokoh pelopor AI”, dan beberapa ahli lainnya memang berpendapat bahwa model bahasa seperti ChatGPT ini secara sistematis tidak akan pernah bisa memiliki kecerdasan atau kemampuan merencana yang setara dengan manusia. Namun, mereka tetap mengakui bahwa alat ini punya kegunaan, asalkan kita tidak tertipu oleh promosi berlebihan dari perusahaan teknologi yang hanya ingin menaikkan harga saham atau menarik investor. Sebuah taktik yang sering disebut sebagai “AI washing”.
Kunci utama untuk menggunakan AI dengan benar adalah dengan tetap melibatkan manusia sebagai “supervisor” untuk menjaga akurasi dan integritas data, terutama untuk tugas-tugas berkepentingan tinggi dan kritis. AI sangat hebat untuk membantu kita memulai sesuatu dari nol, misalnya saat kita bingung harus mulai menulis dari mana. Ia bisa menyusun kerangka laporan hanya dalam hitungan detik.
Dan disinilah tugas penting manusia dimulai. Sebagai supervisor, kitalah yang harus memeriksa setiap pernyataan, memverifikasi setiap kutipan, dan memastikan nada tulisan sesuai dengan kenyataan di dunia nyata yang tidak dipahami oleh mesin. Semua data spesifik seperti angka, nama, atau pasal hukum yang dibuat oleh AI wajib kita periksa secara manual. Jika AI memberikan sebuah referensi, kita harus mencarinya sendiri di sumber aslinya. Jangan pernah langsung percaya setelah bertanya balik kepada AI seperti, “Apakah referensi ini benar?” karena mesin tersebut cenderung akan menjawab “Ya” hanya agar Anda merasa puas, lakukan pendekatan campuran dimana kita tidak hanya bertanya lebih kritis terhadap AI tapi juga verifikasi silang dengan sumber dari luar AI.
Problem Solved?
Sayangnya, belum tentu. Strategi menjadikan manusia sebagai “supervisor” yang hanya bertugas mengecek hasil akhir AI ternyata menyimpan bahaya tersembunyi. Sebuah studi berjudul “How AI Impacts Skill Formation” mengungkapkan dampak mengkhawatirkan dari penggunaan AI terhadap kemampuan kita dalam jangka panjang.
Studi tersebut mengungkap bahwa pengembang perangkat lunak yang mengandalkan AI dalam bekerja mendapatkan skor 17% lebih rendah saat diuji pemahamannya dibandingkan pengembang perangkat lunak lainnya yang melakukan proses pengembangan secara manual. Meskipun mereka bisa menyelesaikan tugas sedikit lebih cepat, mereka gagal memahami logika dasar dari apa yang mereka kerjakan. Secara sederhana, mereka bisa memberikan hasil, tapi tidak benar-benar mengerti bagaimana hasil itu didapatkan.
Peneliti mengidentifikasi beberapa pola penggunaan AI yang berbeda dan menyimpulkan bahwa cara kita menggunakan AI menentukan apakah keterampilan kita akan mengalami atrofi (penyusutan) atau tidak. Pengguna yang “menyerahkan” seluruh proses berpikirnya kepada AI rentan terkena Jebakan Delegasi (The Delegation Trap), dimana keterampilan mereka mengalami penyusutan atau pelemahan karena otak tidak lagi dilatih untuk memecahkan masalah. Sebaliknya, mereka yang menempatkan AI sebagai “tutor” atau teman diskusi (seperti meminta penjelasan), maupun menggunakan AI untuk memverifikasi logika mereka sendiri, cenderung akan tetap bisa menjaga keahlian mereka sambil tetap mendapatkan manfaat dari teknologi tersebut.
Berlawanan dengan anggapan umum bahwa AI menghemat waktu, studi ini membeberkan bahwa waktu yang awalnya dihemat oleh AI sering kali habis kembali untuk memberikan instruksi yang detail, memberi konteks, hingga memperbaiki kesalahan-kesalahan kecil yang dibuat oleh mesin tersebut. Uniknya, meskipun data menunjukkan tidak ada percepatan waktu yang nyata, bahkan saat pekerjaan mereka sebenarnya melambat karena harus terus-menerus mengoreksi AI, mereka tetap merasa bekerja jauh lebih cepat.
More Problems?
Sayangnya, iya. Di atas kertas, AI memang terlihat seperti asisten yang membuat beban kerja jadi lebih ringan. Namun kenyataannya, ada sisi gelap yang mulai muncul, yaitu AI Fatigue atau kelelahan akibat AI. Meskipun AI bisa membuat draf dengan sangat murah dan cepat, ia justru menambah beban dan tekanan baru di pundak kita: beban untuk terus-menerus memeriksa, memperbaiki, dan mengambil keputusan dalam upaya mengimbangi laju produksi AI yang cepat.
Masalah ini diperparah oleh tekanan mental dari ekspektasi lingkungan. Banyak orang beranggapan bahwa “karena sudah memakai AI, pekerjaan seharusnya selesai jauh lebih cepat.” Padahal, kadang kenyataannya justru sebaliknya. Proses memeriksa kesalahan AI ternyata sangat menguras energi sekaligus berisiko memperlambat pekerjaan.
Kesimpulan: Menavigasi Paradoks AI
Kita harus sadar bahwa AI bukanlah pengganti utuh yang bisa dilepas bekerja sendirian. Supervisi manusia tetap wajib, namun tetap memperhatikan beberapa hal. Jika kita mengawasi dengan cara yang pasif, kita akan masuk ke dalam Jebakan Delegasi. Akibatnya fatal: bagi pemula, mereka tidak akan pernah benar-benar belajar, sementara bagi profesional, keahlian yang sudah dimiliki perlahan akan menyusut karena otak tidak lagi dilatih untuk berpikir. Atrofi kemampuan ini terjadi tanpa kita sadari, mengikis ketajaman intelektual yang telah kita bangun selama bertahun-tahun demi kenyamanan sesaat.
Alih-alih menyerahkan nalar kita bulat-bulat, gunakanlah AI dengan lebih bijak. Lakukan verifikasi berlapis. Jangan pernah percaya hanya pada satu sumber, apalagi jika sumber itu adalah AI. Selalu bandingkan logika dan datanya dengan sumber luar yang sah. Selain itu, tempatkan Cognitive Engagement (Keterlibatan Aktif) sebagai sebuah keharusan. Jadikan AI sebagai mitra diskusi, bukan sekadar alat otomatisasi. Selalu tanyakan, “Kenapa hasilnya bisa seperti ini?” Jika kita berhenti bertanya, kita akan kehilangan kemampuan untuk mendeteksi kesalahan saat akurasi menjadi hal yang paling krusial. Kita akan menjadi pengawas yang perlahan lupa cara mengawasi.
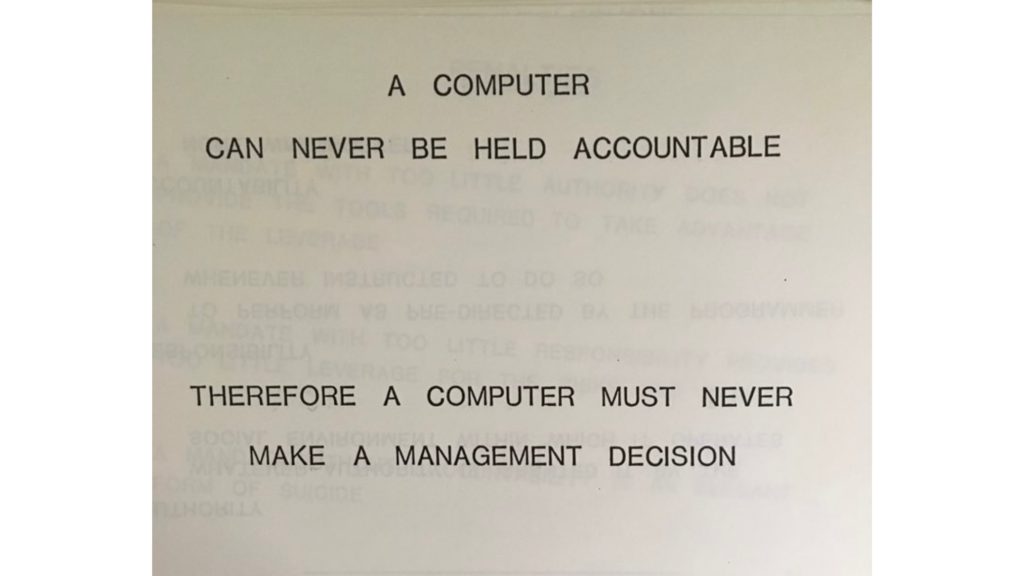
Kita juga harus bisa menerima kenyataan bahwa menggunakan AI secara bijak itu membutuhkan waktu. Kecepatan AI tetap akan dibatasi oleh laju pemahaman manusia. Pemahaman yang sejati tidak datang dari hasil yang instan, melainkan dari proses mencoba, gagal, dan memperbaiki. Sebab, tanggung jawab moral atas hasil akhir sebuah pekerjaan tetap berada di pundak manusia, bukan pada algoritma yang tidak memiliki nurani. Proses ini mungkin tidak cepat, namun inilah yang memberikan hasil yang berkelanjutan. Kita hanya akan berakhir dengan AI Fatigue jika kita mengabaikan batas kemampuan kita.
Menjaga Keberlanjutan, Bukan Hanya Kecepatan
Dalam konteks yang lebih luas, ini bukan sekadar soal teknologi, melainkan soal menjaga kelangsungan kemampuan kita sebagai manusia. Sama halnya dengan isu lingkungan, keberlanjutan tidak selalu bicara tentang seberapa cepat kita bisa melangkah, melainkan tentang bagaimana melakukannya dengan benar dalam jangka panjang.
Mungkin, di tengah dunia yang terobsesi dengan kecepatan instan ini, kemampuan untuk tetap berpikir secara sadar dan mendalam adalah sumber daya kita yang paling berharga. Meski prosesnya lambat dan melelahkan, justru melalui proses alami inilah kemampuan berpikir kita bisa benar-benar tumbuh dan mengakar. Sebagaimana kita berjuang menjaga kelestarian hutan demi masa depan, kita juga harus menjaga kemampuan berpikir agar tidak “lenyap” ditelan kecepatan zaman.
Daftar Pustaka:
- Dolan, E. W. (2025). Users of generative AI struggle to assess their own competence. PsyPost.
- Freifeld, K., & Scarcella, M. (2026, April 21). Sullivan & Cromwell law firm apologizes for AI ‘hallucinations’ in court filing. Reuters. Dolan, E. W. (2025). Users of generative AI struggle to assess their own competence. PsyPost.
- Judge, M. (2025). Where’s the Shovelware? Why AI Coding Claims Don’t Add Up. Mike Loves Robots.
- Khare, S. (2026). AI Fatigue is Real: The Paradox of Automation. SiddhantKhare.com.
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Liang, P., & Potts, C. (2023). Lost in the middle: How language models use long contexts. arXiv preprint arXiv:2307.03172.
- McCool, A. (2024, Februari 22). Air Canada’s chatbot misled a passenger. Who’s to blame?. BBC Travel. Dolan, E. W. (2025). Users of generative AI struggle to assess their own competence. PsyPost.
- Pratt, M. (2025, Oktober 7). Deloitte Australia to refund government after AI ‘hallucinations’ found in $440,000 report. Fortune. Dolan, E. W. (2025). Users of generative AI struggle to assess their own competence. PsyPost.
- Judge, M. (2025). Where’s the Shovelware? Why AI Coding Claims Don’t Add Up. Mike Loves Robots.
- Khare, S. (2026). AI Fatigue is Real: The Paradox of Automation. SiddhantKhare.com.
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Liang, P., & Potts, C. (2023). Lost in the middle: How language models use long contexts. arXiv preprint arXiv:2307.03172.
- Shen, J. H., & Tamkin, A. (2025). How AI Impacts Skill Formation: The Risk of Technical Atrophy (Research Paper).
- Weiser, B. (2023, Mei 27). Here’s what happens when a lawyer uses ChatGPT. The New York Times. Dolan, E. W. (2025). Users of generative AI struggle to assess their own competence. PsyPost.